من هر روز از ابزارهای هوش مصنوعی استفاده میکنم، برای کارهایی که هیچ ربطی به هم ندارند. یک هفته برای یک خط لوله انتشار (publishing pipeline) است، هفته بعد یک مانیتور توییتر است که اختلالات خطوط هوایی را شناسایی میکند، و هفته بعد چیزی کاملاً نامربوط. برای مدت طولانی «سیستم» من، در واقع نداشتنِ سیستم بود: یک چت جدید باز کن، کار را انجام بده و برو. این روش تا زمانی که دیگر جواب نداد، به خوبی کار میکرد.
این روزها همه آن کارها در ابسیدین (Obsidian) زندگی میکنند. این نرمافزار به مغز دوم من تبدیل شده است. در این پست نشان خواهم داد که چگونه کار میکند، دستورات کوچکی را که کارهای اصلی را انجام میدهند به اشتراک میگذارم، و به دو سوالی که خودم داشتم پاسخ میدهم: آیا مهم است که کدام مدل هوش مصنوعی یادداشتها را بنویسد، و آیا هیچ یک از اینها به یک ابزار خاص هوش مصنوعی محدود شده است؟
روش نامرتبی که قبلاً کار میکردم
در اینجا الگویی وجود دارد که بسیاری از افراد در آن گرفتار میشوند. شما یک چت را برای یک پروژه باز میکنید و آن را برای هفتهها باز نگه میدارید، و هر چند پیام یکبار آن را فشرده میکنید. این همان قابلیتی است که در آن هوش مصنوعی مکالمه را تا اینجای کار خلاصه میکند تا بتواند بدون رسیدن به محدودیت طول متن، به کار ادامه دهد.
اگر این روش برای شما کار میکند، بگذارید همینطور بماند. اما برای من، این بهترین گزینه نبود. من کارهای نامربوطی داشتم که همزمان اجرا میشدند، بنابراین در نهایت با دهها چت جداگانه روبرو شدم. و اینجا بود که همهچیز از هم پاشید:
- من فراموش میکردم که کدام چت مربوط به کدام مکالمه است.
- گاهی اوقات نمیتوانستم چت مناسب را پیدا کنم، بنابراین کل داستان قبلی را از ابتدا دوباره توضیح میدادم.
- گاهی اوقات کلاً فراموش میکردم که یک چت وجود دارد و بعداً تصمیمی میگرفتم که بیسروصدا در تضاد با چیزی بود که هفتهها پیش حل کرده بودم.
هیچکدام از اینها تقصیر هوش مصنوعی نبود. کار من به سادگی در یک رشته گفتگوی طولانی نمیگنجد، و تظاهر به اینکه میگنجد هرگز قرار نبود جواب دهد.
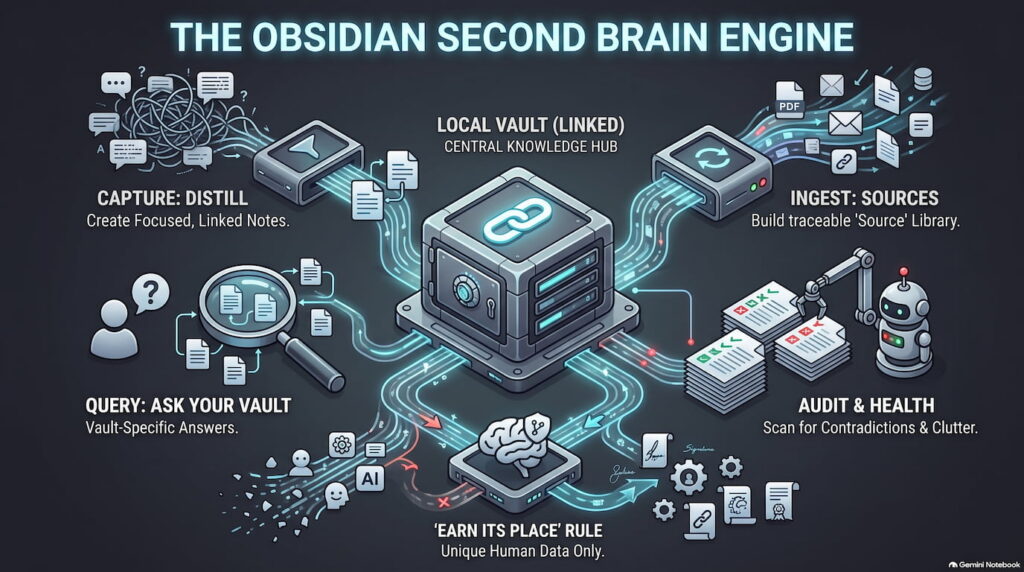
ساخت یک مغز دوم واقعی
این ایده از من نیست. من اولین بار آن را در چیزی که آندری کارپاتی (Andrej Karpathy) توصیف کرد دیدم: به جای اینکه اجازه دهید تاریخچه چت شما به گورستانی از مکالمات قطع شده تبدیل شود، یک ویکیِ زنده (living wiki) نگه دارید که هوش مصنوعی هم از آن میخواند و هم در آن مینویسد. من نسخه سفارشیِ خودم را در ابسیدین ساختم.
نسخه کوتاه این است: هر جلسه به یادداشتهای کوچک و متمرکز خلاصه میشود، هر ایده در یک یادداشت، به گونهای نوشته میشود که مستقل باشد؛ و آن یادداشتها به یکدیگر پیوند میخورند (لینک میشوند). خود ابسیدین فقط یک نمایشگر زیبا برای پوشهای از فایلهای متنی ساده است، که بیشتر از آنچه به نظر میرسد اهمیت دارد. در ادامه به این موضوع برمیگردم.
تا به حال از ابسیدین استفاده نکردهاید؟ راهاندازی آن واقعاً دو دقیقه طول میکشد.
آن را به صورت رایگان از obsidian.md دانلود کنید (نیازی به حساب کاربری نیست)، آن را باز کنید، روی «ایجاد خزانه جدید» (Create new vault) یا اگر از قبل پوشهای از یادداشتها دارید روی «باز کردن پوشه به عنوان خزانه» (Open folder as vault) کلیک کنید. یک مکان در رایانه خود (یا پوشه ابری مشترک) انتخاب کنید، و تمام. این کل فرآیند نصب است. همه چیز در این پست فقط فایلهای متنی داخل آن پوشه است؛ وظیفه ابسیدین این است که آنها را به زیبایی نمایش دهد و به شما اجازه دهد بین آنها کلیک کنید.
خزانه شکل سادهای دارد:
My Notes · ساختار خزانه
My Notes/
├── rules.md # دفترچه قانونی که هوش مصنوعی در هر جلسه از آن پیروی میکند
├── index.md # همه یادداشتها، لیست شده بر اساس دستهبندی
├── log.md # تاریخچه لاگ فقط-افزودنی از کارهایی که هوش مصنوعی انجام داده
├── raw/ # فایلهای اصلی که وارد میکنم (مقالات، PDFها) و هرگز ویرایش نمیشوند
└── wiki/
├── sessions/ # یک یادداشت برای هر مکالمه هوش مصنوعی
├── sources/ # یک یادداشت خلاصه به ازای هر فایل در پوشه raw/
├── concepts/ # ایدهها و روشها
├── entities/ # افراد، ابزارها، شرکتها
└── syntheses/ # پاسخهای خوب به عنوان یادداشت بایگانی میشونددفترچه قانون (rulebook) قلب این سیستم است. این فایل به هوش مصنوعی میگوید که هر پوشه برای چیست، یک یادداشت چه شکلی است، و مهمتر از همه، قوانین نوشتن آنها را مشخص میکند. هوش مصنوعی در ابتدای هر جلسه آن را میخواند، بنابراین هر جلسه طبق همان قوانین پیش میرود.
دستور ثبت (The Capture Command)
این بخشی است که کل کار را پایدار میکند، بنابراین ارزش توضیح دادن را دارد. اگر فقط یک چیز را از این پست کپی میکنید، این یکی را کپی کنید!
در پایان یک جلسه من یک دستور را تایپ میکنم: /capture. در ابزار Claude Code این یک «دستور اسلش» است، که چیزی جز یک فایل متنی با دستورالعملهایی نیست که وقتی من آن را فرامیخوانم، هوش مصنوعی اجرا میکند. دستور من به هوش مصنوعی میگوید که یک یادداشت جلسه بنویسد (اینکه چه کاری کردیم، چه تصمیماتی گرفتیم، قدم بعدی چیست)، ایدههای قابل استفاده مجدد را در یادداشتهای جداگانه استخراج کند، همه چیز را به هم پیوند دهد، و فایلهای ایندکس و لاگ را بهروز کند. بدون رونوشتِ چت. چتِ خام در ابزار باقی میماند، خزانه فقط نسخه تقطیر شده و خلاصه را دریافت میکند.
تنها قانونی که بیشترین اهمیت را دارد، در واقع در حین نوشتن این پست یاد گرفتم. من از هوش مصنوعی کِلود (Claude) خواستم که پیامِ دستورِ ثبتِ (capture prompt) مرا مرور کند، و او یک نقص پیدا کرد: دستورالعمل من میگفت «هر ایده قابل استفاده مجددی، یادداشت مخصوص به خود را میگیرد.» به نظر خوب میرسد، اما کلمه «هر» هیچ مانعی برای ارزیابی به هوش مصنوعی نمیدهد. و من این را میدانم چون اتفاق افتاده است: وقتی بعداً کل خزانه را بررسی کردم، متوجه خُردهنوشتههای دایرةالمعارفی شدم: یادداشتی که یک اختراع در سال ۱۹۴۵ را توضیح میداد، یا صفحاتی که دفترچه قانون خودم را بازگو میکردند. همه اینها از همان روز اول، قبل از وجود قانون، نوشته شده بودند و کاملاً بیفایده بودند. هوش مصنوعی از قبل همه اینها را میداند. بنابراین قانون به این شکل تغییر کرد:
معیاری که هر یادداشت باید از آن عبور کند: باید چیزی خاص من را ثبت کند – یک تصمیم، یک ترجیح، یک محدودیت، یک واقعیت در مورد تنظیمات من – که یک هوش مصنوعیِ جدید از قبل نمیداند. دانش عمومی هرگز یادداشتی دریافت نمیکند. هر جلسه بین صفر تا چهار یادداشت تولید میکند، و صفر هم کاملاً قابل قبول است.
*(نه یک خط تیره، توسط یک انسان اضافه شده!)*
در اینجا نسخه عمومی دستورالعملهای ثبت من آمده است که میتوانید از آن استفاده کنید:
capture.md · پرامپت ثبت
When I run /capture:

1. Write a session note in wiki/sessions/YYYY-MM-DD-topic.md:
   what we did, decisions made (each with its one-line why), next steps,
   open threads.

2. Distill atomic notes, selectively. An idea only gets its own note if:
   a) it's specific to me, a decision, preference, constraint, or fact
   about my setup that a fresh AI wouldn't already know (general knowledge
   never gets a note), AND
   b) I'll plausibly need it again outside this session.
   Check index.md first. Update an existing note instead of creating a duplicate.
   Most sessions produce 0–4 notes. Zero is fine.

3. Cross-link the session note and the atomic notes to each other.

4. Update index.md and append one line to log.md.

5. Distilled notes only, never a transcript.
آیا این کار باعث پر شدن بیش از حدِ زمینه (Context) هوش مصنوعی نمیشود؟
پیوست کردن خزانه من، یادداشتها را در دسترس قرار میدهد، نه اینکه آنها را به طور خودکار بارگذاری کند. هوش مصنوعی از یک ایندکس (Index) برای یافتن و خواندن تنها چند یادداشت مربوط به هر سوال استفاده میکند، بنابراین هزینه پردازش به سوال بستگی دارد، نه به حجم کلی خزانه.
ثبت کردن تنها راه ورود نیست
دستور Capture یک عادت روزانه است، اما خزانه با چهار دستور کار میکند، و همه آنها فقط پرامپتهای (prompts) ذخیره شده هستند:
| دستور | کاری که انجام میدهد | چه زمانی اجرا میشود |
|---|---|---|
/capture |
جلسه را به یادداشتهای پیونددار تقطیر میکند: چه کردیم، چه تصمیمی گرفتیم، مرحله بعدی چیست | در پایان هر جلسه |
/ingest |
فایلی را که در پوشه raw/ قرار گرفته میخواند، یک یادداشت خلاصه مینویسد و آن را به همه چیزهای مرتبط پیوند میدهد | وقتی دانش به صورت یک فایل به دست میرسد، نه از طریق چت |
/query |
به این سوال پاسخ میدهد «یادداشتهای من در مورد موضوع X چه میگویند؟» همراه با لینک به یادداشتهای مرتبط با پاسخ | هر زمان که قبل از تصمیمگیری نیاز به بررسی چیزی داشته باشم |
/lint |
کل خزانه را برای یافتن تناقضات، ادعاهای قدیمی، یادداشتهای تکراری و یادداشتهای یتیم اسکن میکند | ماهانه، بر اساس یک برنامه زمانی (و فقط گزارش میدهد) |
دستور Ingest (جذب/هضم) شایسته توضیح بیشتری است، زیرا برای دانشی است که به جای مکالمه، در یک فایل زندگی میکند. هوش مصنوعی فایل را میخواند، یک یادداشت خلاصه مینویسد و آن را به هر یادداشت مرتبطی پیوند میدهد. فایل اصلی هرگز ویرایش نمیشود، بنابراین هر ادعایی در ویکی را میتوان به منبع اصلی آن ردیابی کرد. من بیشتر از آن برای یادداشتهای جلسات استفاده کردهام (یادداشتهای من از Granola، یک ابزار یادداشتبرداری هوش مصنوعی استخراج میشوند)، اما هر چیزی که بتوانید به عنوان متن ذخیره کنید واجد شرایط است:
- رشته گفتگوی اسلک (Slack) که در آن تصمیمی واقعاً گرفته شده است،
- یک ایمیل رفت و برگشتی با یک فروشنده،
- گزارشی که کسی برای شما ارسال کرده است،
- مقالهای که میخواهید نگه دارید.
اگر چیزی مهم باشد و متن باشد، میتواند به مغز دوم بپیوندد.
دستور Query (پرسوجو) یک اثر جانبی دارد که انتظار نداشتم اینقدر از آن خوشم بیاید: پاسخهای خوب به عنوان یادداشتهای مستقل بایگانی میشوند، بنابراین حتی پرسیدن سوال نیز ویکی را غنیتر میکند.
و دستور Lint (بررسی سلامت) همان بازبینی است. بررسی که خُردهنوشتههای دایرةالمعارفی روز اول مرا پیدا کرد، دقیقاً همین بود. اکنون آن را در یک برنامه ماهانه قرار دادهام و فقط گزارش میدهد؛ من کسی هستم که اصلاحات را تایید میکنم.
الگو هر بار یکسان است: خزانه چیزی است که دوام میآورد، و هر دستور فقط یک فایل متنی است که به هوش مصنوعی میگوید چگونه آن را حفظ و نگهداری کند.
چه چیزی ارزش تغذیه کردن را دارد
هنگامی که کار با دستور Ingest در ذهن شما جا میافتد، شروع به دیدن کاندیداها در همهجا میکنید. یادداشتهای جلسات تنها چیزهایی هستند که تا به حال برای من به یک عادت تبدیل شدهاند. بقیه این لیست جاهایی است که من میبینم در محل کار و خانه به آن سمت میرود.
| محیط | چه چیزی را تغذیه کنیم | چرا جایگاهی به دست میآورد |
|---|---|---|
| کار | اسناد پروژه در زمان تحویل: PRDها، خلاصهها، مشخصات | آنها را هنگام شروع یک پروژه Ingest کنید، و خزانه الزامات هر جلسه آینده در مورد آن را میداند |
| کار | گزارشهای پس از حادثه و خرابی (Post-mortems) | دانشی درباره «چرا این خراب شد و چه تصمیمی گرفتیم» که در غیر این صورت یک سال بعد به سختی دوباره آموخته میشود |
| کار | تحقیقات کاربر: مصاحبهها، نظرسنجیها، تیکتهای پشتیبانی | هر کدام یک فایل است؛ ویکی آنچه را که مشتریان به طور مداوم در همه آنها میگویند جمعآوری میکند |
| کار | دادههایی که یک بار تجزیه و تحلیل کردید | ارزش در صفحه گسترده نیست، بلکه در نتیجهگیری است: «ما این را در ماه مارس بررسی کردیم، پاسخ منفی بود، این هم دلیلش» |
| کار | بستههای آشناسازی سازمانی (Onboarding) | اسناد کلیدی را در روز اول تغذیه کنید و هوش مصنوعی شما قبل از شما در جریان امور قرار میگیرد |
| شخصی | قراردادها و سیاستها: اجارهنامه، بیمه، گارانتیها | «آیا بیمهنامه من X را پوشش میدهد؟» به سوالی تبدیل میشود که میپرسید، نه یک فایل PDF که برای یافتنش جستجو کنید |
| شخصی | کتابها و دورهها | یادداشتهای فصل که به همه چیزهای دیگری که میدانید پیوند میخورند، به جای یک فایل هایلایت که هرگز دوباره باز نمیکنید |
| شخصی | رونوشتهای پادکست و یوتیوب | دو ایده مفید از یک اپیزود ۹۰ دقیقهای که ثبت شده، پیوند داده شده و قابل جستجو هستند |
فیلتر همان است که در Capture استفاده میشود: چیزهایی را به آن بدهید که بعداً به نتایج آنها نیاز خواهید داشت، نه چیزهایی که میتوانید دوباره در گوگل جستجو کنید. یک رشته گفتگوی Slack واجد شرایط است زیرا تصمیمی که در آن گرفته شده در هیچ کجای دیگر وجود ندارد. یک آموزش عمومی واجد شرایط نیست؛ هر هوش مصنوعی میتواند آن را در صورت تقاضا بازتولید کند.
به خاطر داشته باشید که این یک حافظه نظارتشده (curated memory) است، نه یک انبار داده؛ بیشتر جلسات بین صفر تا چهار یادداشت اضافه میکنند، و دانش عمومی هرگز صفحهای دریافت نمیکند زیرا هوش مصنوعی از قبل آن را میداند. در اینجا، دادههای از دست رفته یک شکست نیستند، بلکه فقط نویز محسوب میشوند.
واقعاً چه چیزی تغییر کرد
اینطور نیست که من فراموش کردنِ چیزها را متوقف کرده باشم، هنوز هم فراموش میکنم. مسئله این است که فراموش کردن دیگر اهمیتی ندارد. روی هر پروژهای که کار میکنم، هوش مصنوعی اطلاعات را از کل ویکی استخراج میکند، نه فقط از یک مکالمهای که اتفاقاً در آن هستم (در عمل: هر پروژهای را که با یک جلسه شروع میکنم، پوشه خزانه را نیز به آن ضمیمه میکنم تا همیشه در دسترس باشد). و تا به حال چند بار پیش آمده است که هوش مصنوعی چیزی را به من یادآوری کرده که خودم فراموش کرده بودم – تصمیمی که گرفته بودم، دلیلی که چیزی را رد کرده بودم – پیش از آنکه همان اشتباه را تکرار کنم. این همان بخشی است که مرا متقاعد کرد.
“این فقط ‘هوش مصنوعی با حافظه’ نیست. این دستیاری است که واقعاً در جریان زندگی من قرار دارد.”
آیا مدلِ هوش مصنوعی اصلاً مهم است؟
من از یک مدل قوی (مانند Opus یا Fable) برای خود جلسه و بخش تفکر استفاده میکنم. اما فرآیند ثبت (capturing) یک مرحله جداگانه است. آیا برای این کار نیز به یک مدل گرانقیمت نیاز است، یا یک مدل ارزانتر و سریعتر مثل Haiku یا Sonnet به اندازه کافی خوب است؟
پاسخ کوتاه: مدل ارزانتر معمولاً خوب است، زیرا این یک نوع کار متفاوت است.
| مرحله | سطح مدل | چرا |
|---|---|---|
| جلسه، کار اصلی | قوی (Opus, Fable) | این جایی است که تفکر اتفاق میافتد: حل مشکل، تصمیمگیری |
| ثبت کردن، نوشتن (Capture) | ارزان و سریع (Haiku, Sonnet) | ثبت کردن فکر کردن نیست، بلکه توجه کردن است: چه چیزی مهم بود، چه چیزی ارزش نگه داشتن دارد، چگونه آن را در یک جمله تمیز بیان کنیم |
دو نکته احتیاطی: جلسات بسیار طولانی میتوانند تنها جزئیاتی که اهمیت داشتند را مدفون کنند، و یک مدل ضعیفتر به احتمال زیاد آنها را به چیزی عمومی و سطحی تبدیل میکند. و پیوند دادن یادداشتهای جدید به یادداشتهای موجود صحیح، نیازمند درک بهتری از همهچیزهایی است که از قبل در ویکی وجود دارند. بنابراین قانون من این است: بهترین مدل برای کار اصلی، مدل ارزان برای نوشتن خلاصهها، به شرطی که دستورالعملهای ثبت شما در مورد آنچه که شایسته یادداشت است مشخص و دقیق باشند. اگر یادداشتها شروع به سطحی شدن و عمومی شدن کردند، این سیگنال شماست تا دوباره از مدل قویتر استفاده کنید.
آیا این سیستم فقط برای هوش مصنوعی Claude است؟
خیر! و این ویژگیِ مورد علاقه من در کل این سیستم است.
خزانه (vault) یک پوشه از فایلهای مارکداون (markdown) ساده است. هیچ پایگاه دادهای در کار نیست، هیچ افزونه جادویی وجود ندارد و به هیچ شرکت خاصی گره نخورده است. هر ابزار هوش مصنوعی که بتواند فایلهای روی رایانه شما را بخواند و بنویسد، میتواند آن را نگهداری کند: Claude Code، OpenAI Codex، Antigravity 2.0، Cursor، هر کدام را که میخواهید انتخاب کنید. تنها جزئیات مربوط به Claude در تنظیمات من، نام یک فایل است: ابزار Claude Code به طور خودکار در ابتدای هر جلسه فایلی به نام CLAUDE.md را میخواند، بنابراین نام دفترچه قانون من همین است. ابزارهای دیگر معادلهای خاص خود را دارند (بسیاری AGENTS.md را میخوانند)، یا به سادگی به آنها میگویید «اول فایل rules.md را بخوان.»
همین امر در مورد دستور Capture نیز صدق میکند. یک «دستور اسلش» (slash command) مختص به یک ابزار به نظر میرسد، اما به معنای واقعی کلمه فقط یک پرامپت است که در یک فایل متنی ذخیره شده است، و امروزه هر ابزار جدی راهی برای ذخیره پرامپتهای قابل استفاده مجدد دارد. در بدترین حالت، دستورالعملهای Capture را به عنوان یک یادداشت در داخل خود خزانه نگه دارید و جلسات خود را با گفتن این جمله پایان دهید: «فایل capture.md را باز کن و کاری که میگوید را انجام بده.»
تنها تنظیمی که خوب کار نمیکند: چتباتهای مبتنی بر مرورگر که دسترسی به فایل ندارند. آنها میتوانند هر چیزی که شما پیست (paste) میکنید را بخوانند، اما نمیتوانند خزانه را برای شما نگهداری کنند، در حالی که نگهداری و حفظ خزانه، تمام هدف این سیستم است.
این یک دلیل بیصدا برای انجام این کار است.
“تاریخچه چت در داخل هر ابزار قفل شده است، ابزارها را تغییر دهید و آن را از دست خواهید داد. خزانه متعلق به شماست. مدلها تغییر خواهند کرد؛ اما پوشه یادداشتها به سادگی روی هم انباشته و غنیتر میشوند.”
اگر به فکر انجام این کار هستید
شما لزوماً به نرمافزار ابسیدین نیاز ندارید. تغییر واقعی، تغییری کوچک در نگرش است: با مکالمات هوش مصنوعی به عنوان چیزهای یکبار مصرف برخورد نکنید، و شروع کنید به هر یک از آنها به عنوان ورودی برای چیزی که در حال رشد است نگاه کنید. بقیه چیزها فقط ابزار و لولهکشی هستند.
اگر سیستم مشابهی ساختید، خوشحال میشوم بشنوم که چگونه آن را انجام میدهید، با من در ارتباط باشید.